 首页 > 产品中心 > 综合与数字实现
一、概述
Synopsys Fusion Compiler是新一代RTL-to-GDSII实现系统,其架构旨在应对先进工艺节点设计的复杂性,在将结果产出时间(TTR)缩短2倍的同时,带来最高20的结果质量(QoR)提升。FusionCompiler构建于紧凑的单一数据模型之上,支持Fusion技术在RTL-to-GDSII全流程中的无缝共享,实现超收敛(Hyper-Convergent)的设计收敛。Fusion Compiler从零开始构建,集成了业界一流的RTL综合、布局布线与签核技术,用于设计最先进的SoC,带来无可匹敌的功耗、性能与面积(PPA)表现、QoR以及快速的设计收敛。FusionCompiler的集成驾驶舱(图1)为设计提供全面平台,涵盖RTL物理综合、设计规划、布局、时钟树综合(CTS)、先进布线、基于物理综合的优化、芯片收尾(Chip Finishing)、签核质量分析与ECO优化。
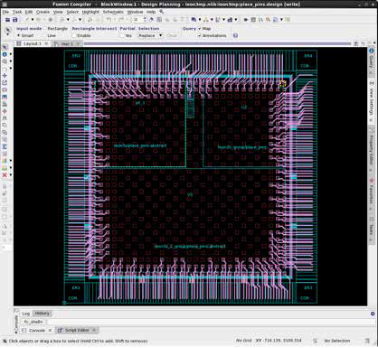
图1:集成的Fusion Compiler RTL-to-GDSII驾驶舱
二、关键优势
- 全面的RTL-to-GDSII设计系统,带来最高20的PPA提升与2倍的TTR缩短
- Fusion数据模型架构,带来无可匹敌的容量、可扩展性与生产力
- 统一的物理综合优化,实现最佳QoR
- 通用布局与2D合法化引擎,实现快速的DRC收敛与设计收敛
- 基于布线估计的精确拥塞估算与预测,提升整体收敛性
- 覆盖全流程的功耗优化,包括独特的功耗驱动重综合与基于拐点(Knee-based)的优化
- 物理感知综合与先进CTS,支撑最高工作频率
- 通过领先代工厂工艺认证的FinFET与多重图形化感知设计
- 签核级时序、寄生参数提取与功耗分析,消除设计迭代
- 从综合到布线后的先进面积回收算法,实现最佳利用率
- 普及式并行化,借助多线程与分布式处理技术实现最大吞吐量
三、 Fusion数据模型
Synopsys Fusion Compiler的单一数据模型同时包含逻辑与物理信息,支持库、数据、约束与设计意图在整个实现流程中的共享。这一先进数据模型经过专门架构设计,以尽可能小的内存占用支持超大规模设计。Fusion Compiler的关键创新在于综合工具与实现工具可相互访问对方的技术,包括在两个领域之间共享优化引擎。Fusion Compiler将所有综合、布局布线与签核引擎集成在单一数据模型之上,消除了数据传输,以最高吞吐量实现最快的设计收敛。
四、2倍更快的结果产出时间
Synopsys Fusion Compiler通过统一物理综合优化流程模糊了综合与物理实现之间的边界,实现从RTL到GDSII的最快周转时间。其可扩展架构可应对先进节点设计的复杂性,原生层次化基础架构可处理数亿实例规模的设计。稳健的系统与完整的功能集支持所有设计风格,在最短时间内生成最优的布局规划配置。贯穿全流程关键引擎的并行化技术——多线程与分布式处理——充分利用硬件资源,实现快速设计收敛与迅速的设计签核。包括综合、布局、优化器、CTS与布线器在内的核心实现引擎均经过重构,显著加快设计实现速度。贯穿Fusion Compiler的签核级质量引擎消除了添加过度设计裕量的需要,并避免了后期收敛问题。
五、 高达20的功耗、性能与面积提升
Synopsys Fusion Compiler提供横跨RTL物理综合与布局布线两个领域的独特创新解决方案,包括布局规划与综合的交织执行、物理感知的数据通路表示、物理实现过程中的逻辑重综合,以及统一的物理综合(UPS)优化——可带来最高20的QoR提升。UPS是Fusion Compiler内所有优化能力的神经中枢与根本基石,它统一了下一代综合与布局布线优化引擎的最优技术,实现更快收敛(图2)。UPS提供诸多先进特性,如层次感知优化、宏单元偏斜(Macro Skewing)、先进2D合法化、用于拥塞建模的布线驱动估计(RDE)、并发时钟与数据(CCD)优化、多位寄存器合并与拆分、以总功耗为中心的优化、自动非默认规则(NDR),以及面向先进节点的通孔阶梯(Via Ladder)支持。
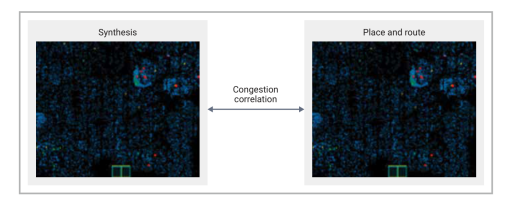
图2:统一物理综合带来无可匹敌的相关性与QoR
六、 AI驱动的自适应流程
自适应流程(Adaptive Flow)无缝集成于Synopsys Fusion Compiler超收敛的综合与布局布线解决方案之中。其主要目标是通过在设计实现过程中根据实时观察结果动态调整设计流程与引擎启发式策略,提升设计效率。AI持续监控并自适应调整流程,即使初始配置效果不佳也能确保设计收敛。与EDA数字设计领域通用的超参数优化AI应用相比,这种方法在优化PPA的同时显著降低了算力需求。
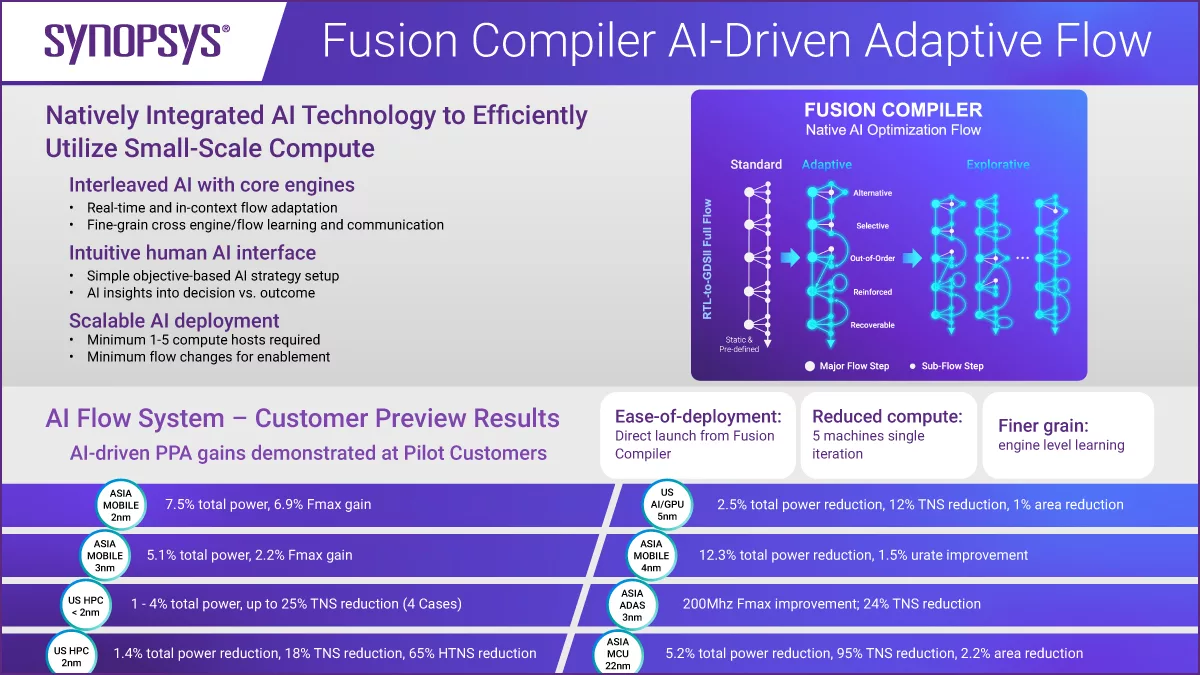
图3:Fusion Compiler AI驱动的自适应流程